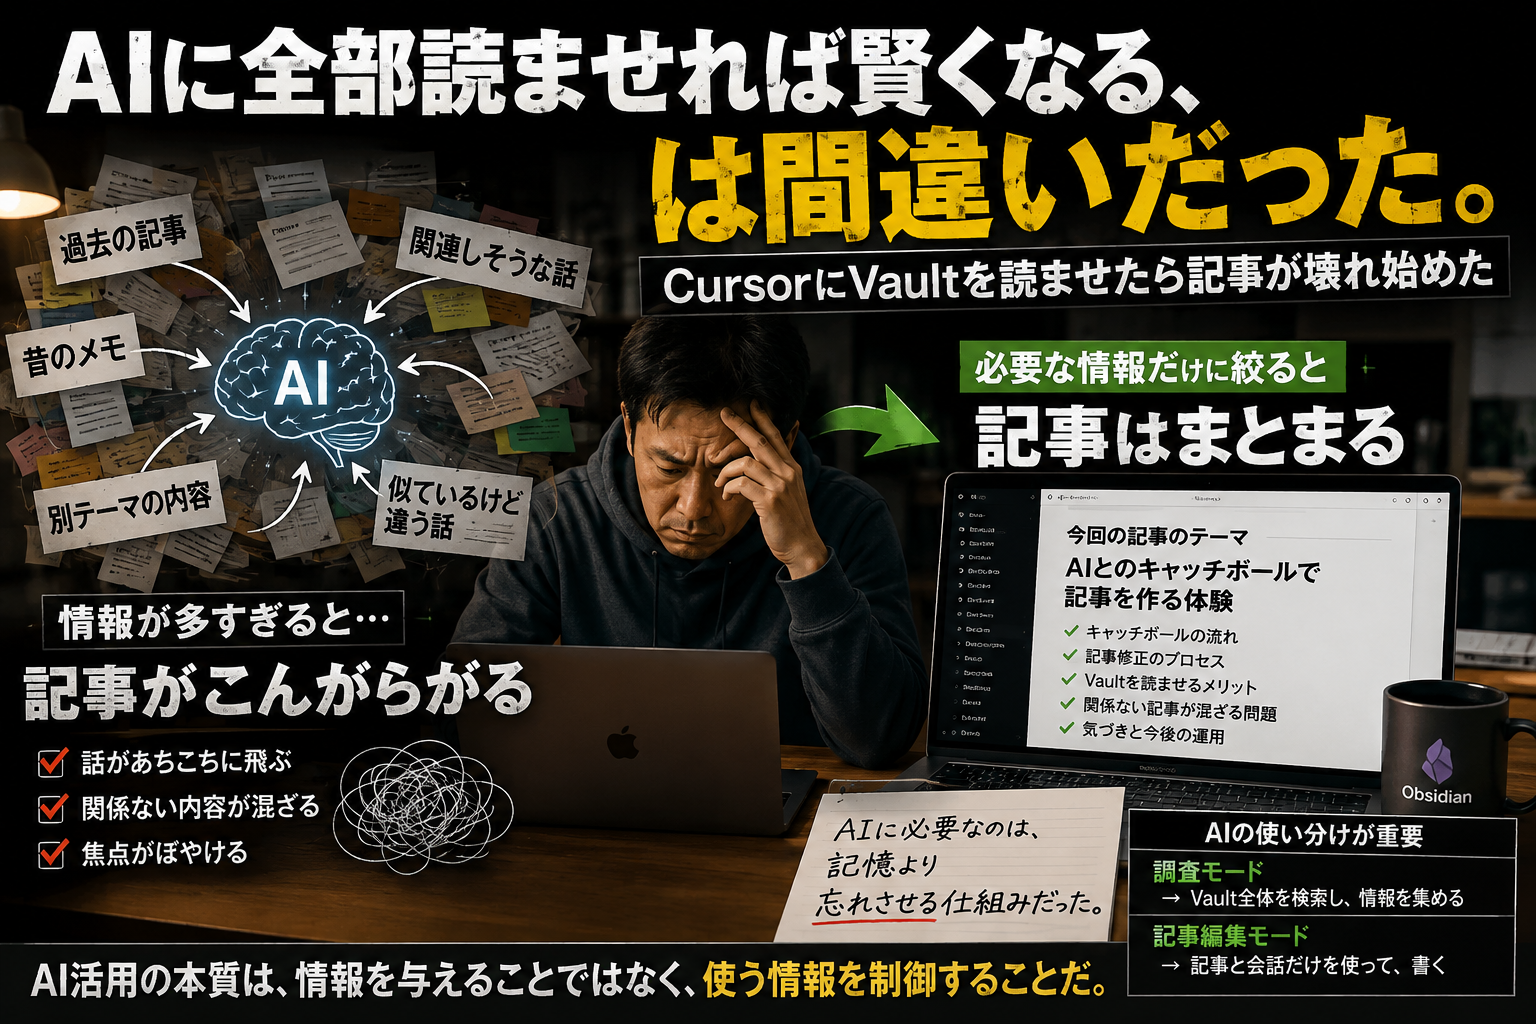
「Cursorに全部読ませればいい」と思ったら記事が混線した。ChatGPTがやたら制限してきた理由が後で分かった
最近、ObsidianとCursorを組み合わせて記事を書くことが増えている。
ただ、私はまだCursorを完全に使いこなしているわけではない。
そのため最初の頃は、Cursorを操作しながら、分からないことがあるたびにChatGPTへ聞いていた。
「Cursorにはどう指示すればいい?」
「このVaultを読ませても大丈夫?」
「記事を直させるにはどうしたらいい?」
そんなことをChatGPTに聞きながらCursorを動かしていた。
そのとき、かなり印象に残ったことがある。
ChatGPTが、とにかくCursorに制限をかけたがるのである。
「このファイルだけを使わせたほうがいい」
「Vault全体を勝手に参照させないほうがいい」
「別の記事を混ぜないように明示したほうがいい」
「今回使う情報を限定したほうがいい」
と、やたら細かい。
私は正直、
「そこまで言わなくてもいいんじゃないか」
と思っていた。
Cursorはかなり優秀だし、こちらも放っておくわけではない。
出来上がった文章を見ながら、こちらで修正すればいい。
そう思っていた。
そこでChatGPTを介さず、自分でCursorを使ってみた
ある程度Cursorの使い方が分かってきたので、今度はChatGPTに逐一聞かず、自分で記事を作ってみることにした。
やりたかったこと自体は、それほど複雑ではなかった。
もともと二つの記事があり、その内容を掛け合わせて一つの記事にしたかった。
つまり、完全な新規記事ではない。
記事Aと記事Bの内容を材料にしながら、新しい一本の記事へ組み直す作業だった。
Cursorにとっては得意そうな仕事に見える。
そして実際、最初はかなりうまくいっていた。
二つの記事から関連部分を拾い、文章をつなぎ、新しい構成にしてくれる。
「これは便利だな」と思った。
ところが、途中から記事が妙にこんがらかってきた。
問題は「2つの記事を混ぜたこと」ではなかった
最初は、二つの記事を掛け合わせたから話が複雑になったのかと思った。
しかし読み返してみると、どうも違う。
本来使うはずだった二つの記事以外の話が入っている。
調べてみると、Cursorが別のメモまで参照していた。
それが問題だった。
今回の記事とは、ほとんど関係のないメモだった。
ところが、そのメモの中に一部似た言葉や話題があったのだろう。
Cursorはそれを
「これも関連情報だ」
と判断したらしい。
つまり今回の構造は、
- 本来使いたかった記事A
- 本来使いたかった記事B
- 関係のないメモC
になっていた。
記事Aと記事Bを掛け合わせること自体は、こちらが意図していた。
問題は、そこへ頼んでいない3つ目のメモまで入ってきたことだった。
一番厄介なのは、完全な間違いではないこと
これがAI文章の難しいところだと思う。
Cursorが持ってきたメモの内容は、完全なデタラメではない。
私自身が以前書いたメモなので、書いてある内容そのものは正しい。
だから文章を一文ずつ読むと、特におかしくない。
しかし今回の記事には関係がない。
結果として、
「なぜここでこの話が出てくるのか?」
という文章になる。
情報自体は正しい。
文章もそれなりに自然。
しかし記事全体としては焦点がずれていく。
これが、いわゆる「ノイズ」なのだと思う。
「そのメモを混ぜないで」と言ったら、かなり戻った
そこでCursorに、
「そのメモの内容は今回の記事とは関係ないので混ぜないでほしい」
と伝えた。
すると、文章はかなり整理された。
完全に最初の状態へ戻ったわけではない。
すでに二つの記事を掛け合わせながら編集を進めていたので、そこからさらに修正した文章になっている。
しかし、明らかにノイズは減った。
ここで改めて感じたのは、Cursorそのものが悪いわけではないということだ。
むしろCursorは優秀だからこそ、関連情報を積極的に探してくる。
問題は、
「関連しているように見える情報」と「今回使うべき情報」が同じではない
ということだった。
ここでChatGPTの「うるささ」を思い出した
このとき、最初にChatGPTへ相談しながらCursorを使っていた頃のことを思い出した。
ChatGPTはやたらと、
「参照させるファイルを限定したほうがいい」
「関係ないメモを読ませないほうがいい」
「今回使う範囲を決めたほうがいい」
と言っていた。
そのときの私は、
「ずいぶん神経質だな」
と思っていた。
Cursorを放っておくつもりはない。
文章を見ながら自分で修正するのだから、それほど厳密に制限しなくてもいいだろう。
そう考えていた。
ところが実際に自分だけで使ってみると、まさにChatGPTが警戒していたことが起きた。
今になってみると、あの細かい制限には意味があった。
AIに大量の情報を読ませることには、別の難しさがある
ObsidianとCursorの組み合わせは、非常に便利だ。
大量のメモを保存しておき、必要になったらAIに探してもらえる。
以前何を書いたか忘れていても、Cursorなら関連しそうなファイルを見つけてくれる。
これは大きなメリットだ。
しかし今回の経験で、もう一つ分かった。
情報をたくさん持たせるほど、ノイズを拾う可能性も増える。
検索するときは、それでもいい。
候補をたくさん出してもらい、人間が選べばいい。
しかし記事を書く場合は違う。
AIがそのまま文章へ混ぜ込んでしまう。
すると、関係の薄い情報でも、文章の中では自然につながって見えてしまう。
だから発見が遅れる。
「全部読めるAI」と「全部使うAI」は違う
ここは、今回かなり重要な気づきだった。
私はこれまで、AIがVault全体を読めることを大きなメリットだと考えていた。
これは今でも変わらない。
ただし、
全部読めることと、全部使っていいことは全く別だ。
AIは大量の情報へアクセスできてもいい。
しかし記事を書くときには、
「今回はこの二つの記事だけ」
「このメモは使わない」
「似た内容があっても勝手に追加しない」
という境界線が必要になる。
つまり必要なのは、AIの記憶を増やすことだけではない。
その記憶の中から、今回どれを使わせるかを制御することだった。
Cursorは調査と執筆で使い方を変えたほうがよさそうだ
今回の経験から、Cursorには少なくとも二つの使い方があると考えるようになった。
調査するとき
Vault全体を検索させる。
関連しそうな記事やメモを幅広く探してもらう。
多少ノイズがあっても構わない。
最後に人間が判断すればいい。
記事を書くとき
使うファイルをできるだけ限定する。
必要なら二つ、三つと指定する。
ただし、それ以外を勝手に追加しないようにする。
関連する別メモを見つけても、本文へ混ぜる前に止める。
この二つを同じ感覚で使うと、記事は簡単に混線する。
「第二の脳」は作るだけでは足りなかった
私は最近、Obsidianへ大量の情報を集めている。
自分のメモ、過去の記事、AIとの相談、思いつき。
それをAIから検索できるようにしていく。
いわゆる「第二の脳」に近い使い方だ。
この方向自体は、かなり便利だと思っている。
しかし第二の脳を作れば、それだけでAIが賢くなるわけではなかった。
むしろ情報が増えてくると、新しい問題が出てくる。
どの記憶を使わせるか。
どの記憶を今回は無視させるか。
こちらの設計が必要になる。
ChatGPTに相談しながらCursorを使っていた頃は、
「また制限の話か」
と思っていた。
ところが一人で使ってみたら、記事Aと記事Bを掛け合わせているところへ、関係のないメモCまで入り込んできた。
そこで初めて、制限の意味がよく分かった。
Cursorは優秀だった。
だからこそ、こちらが止めなければ、関連しそうなものをどんどん拾ってくる。
AIを使いこなすというのは、何でも読ませることではない。
読める状態にしておきながら、「今回はこれだけ使え」と指示できること。
どうやら、そこが次の段階らしい。
コメント