この記事にはアフィリエイト広告が含まれています。
前の記事で、私はNottaを会議のリアルタイム文字起こしにはあまり使わず、録音済みの講演や勉強会を後から文字にするために使っていると書きました。
ただし、文字起こしが終わっても、それで作業終了ではありません。
むしろ私の場合、そこからが本番です。
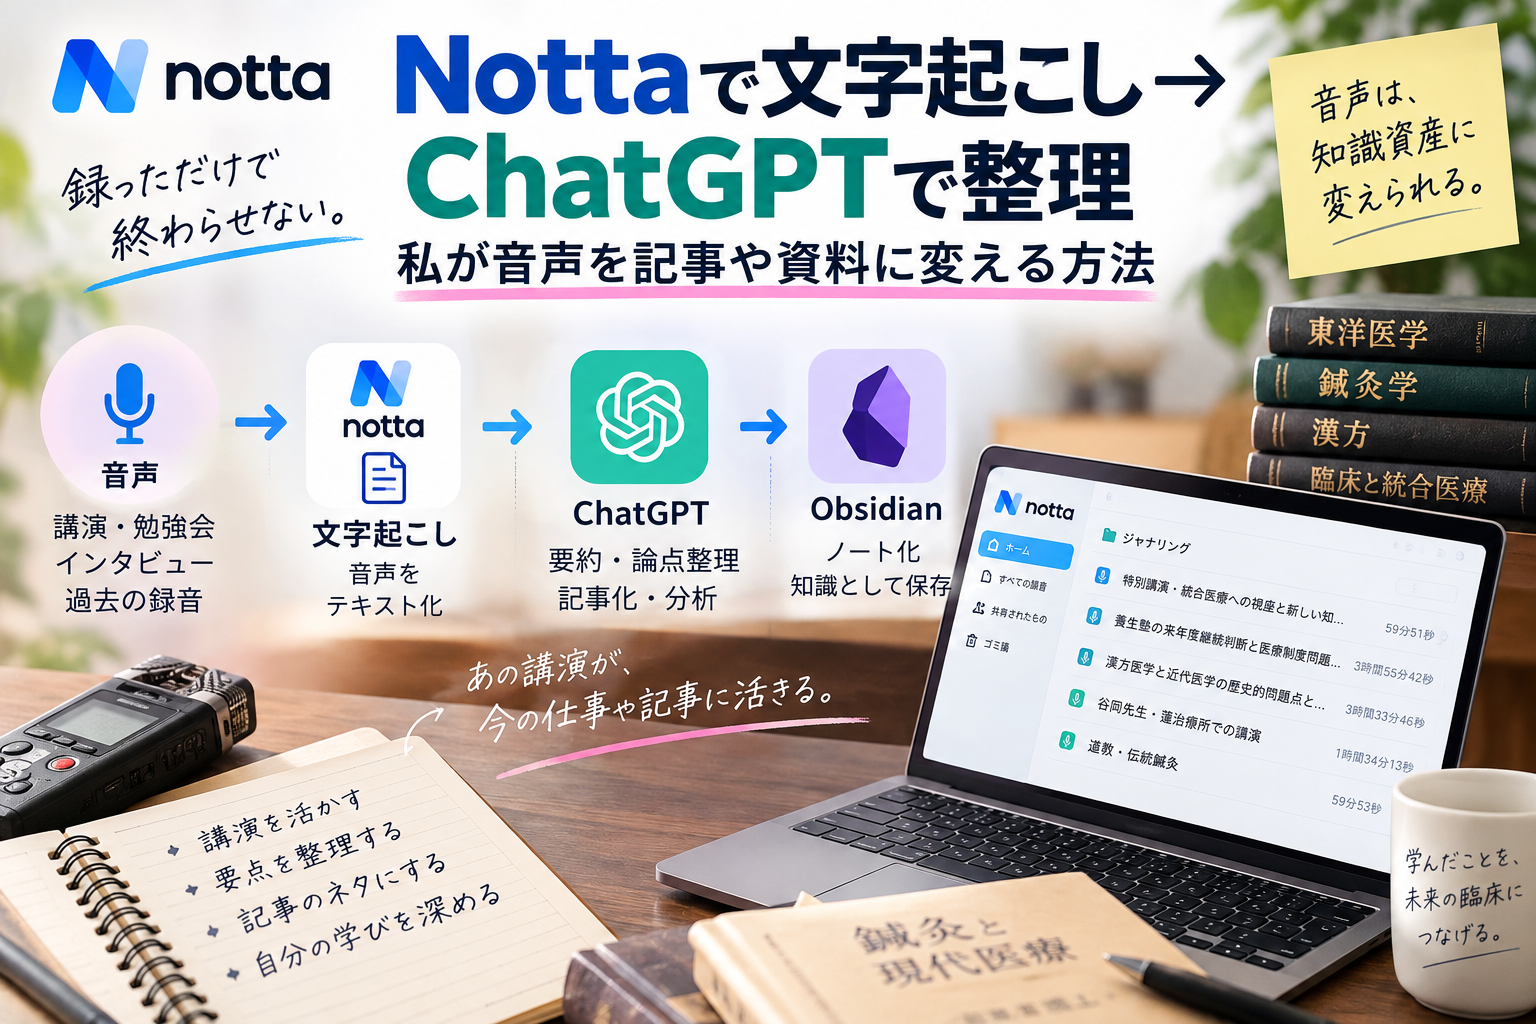
Nottaで音声をテキストにし、そのテキストをChatGPTなどのAIに読ませて整理する。
現在はこの形に落ち着いています。
以前は「録音しただけ」で終わっていた
講演や勉強会を録音しても、その音声を活用するのは意外に大変です。
1時間の講演なら、確認するためには基本的に1時間聞く必要があります。
途中に重要な話があった記憶はあっても、「何分頃だったか」が分からなければ探すだけでも時間がかかります。
私も長年録音してきた資料がありますが、録音したことで安心して、そのままになっていた音源も少なくありません。
第1段階はNottaでテキスト化
まず録音済みのファイルをNottaに入れます。
ここでは、完璧な文章を作ることを期待していません。
講演の内容がある程度追える状態でテキストになれば、次のAI処理へ進めるからです。

第2段階はAIに「何を知りたいか」を伝える
文字起こしした文章をAIに渡します。
ここで単に「要約してください」とするだけでは、せっかくの長時間音源を十分に活用できません。
目的によって指示を変えます。
- 講演全体の要点を整理する
- 重要な発言だけを抽出する
- テーマ別に分類する
- ブログ記事になりそうなテーマを探す
- 自分の研究テーマに関係する部分だけを抽出する
- Obsidianへ保存する研究メモに整える
同じ音源でも、質問を変えれば違う資料として再利用できます。
AIを使うようになって文字起こし精度への考え方も変わった
以前なら、文字起こしというと「一字一句正確に起こす」ことが重要だと思っていました。
もちろん、引用したり、人名や固有名詞を記録したりする場合には原音確認が必要です。
一方、講演の論点を把握したり、内容を分類したりするためなら、多少の誤変換があってもAIは前後関係からかなり読み取れます。
そのため私は、Nottaに完成原稿を作ってもらうというより、AIが内容を読める状態まで音声を変換してもらうと考えています。
専門用語は最後に人間が確認する
私は鍼灸、按摩、東洋医学など専門用語の多い音源を扱います。
この分野では、似た音の漢字や人名、古典の書名などが誤変換されることがあります。
ですから、AIがきれいな文章に直してくれたからといって、そのまま事実として使うのは危険です。
特に引用、人名、書名、年代などは必要に応じて音声や原資料へ戻ります。
逆に言えば、すべてを最初から人間が聞き直すのではなく、確認が必要なところだけ原音に戻るという使い方ができます。
第3段階はObsidianなどへ残す
AIで整理した内容は、その場で読んで終わりにせず、必要なものはObsidianなどへ保存しています。
音声だけでは検索しにくかった資料が、文章になり、さらにテーマごとのノートになります。
こうすると、数年前の講演と最近読んだ論文を後から結び付けることもできます。
役割を分けると使いやすい
現在の私の使い分けは単純です。
- Notta:音声をテキストへ変換する
- ChatGPTなどのAI:内容を整理・分析する
- Obsidian:後から使える形で保存する
全部を一つのサービスでやろうとしない方が、かえって使いやすいと感じています。
文字起こしはゴールではなく入口だった
Nottaを使い始めた頃は、文字起こしそのものが目的でした。
しかしAIを使うようになってからは、文字起こしに対する考え方が変わりました。
音声を文字にすることは、音声の中身をAIで扱えるようにするための入口です。
この違いはかなり大きいと思っています。

※Nottaの料金・利用条件・機能は変更される場合があります。最新情報は申込画面で確認してください。

コメント